








人間の心理特性や行動傾向を再現可能なヒューマン・デジタルツイン(HDT)は、高度な分析や最適化、人の心にきめ細やかに寄り添うサービスの提供などを通じて、多様な分野での活用が期待されています。しかし、心理特性や感情に関わる情報は機微なもので、慎重な取り扱いが求められます。とりわけ個人単位で動作するHDT(TypePのHDT)では、本人のコントロールが及ばないかたちで機微な情報が蓄積・活用される可能性があります。こうした特性を踏まえると、保護の在り方を各事業者の自主的な判断に委ねるには限界があります。今回のコラムでは、HDTがもたらすプライバシーリスクを整理し、利活用と保護を両立させるために求められる設計・制度上の課題と方向性を検討します。
ヒューマン・デジタルツインの社会実装:プライバシー設計
心とデジタルの融合(5)
タグから探す
2026年04月24日
自己増殖するヒューマン・デジタルツインの機微情報
ヒューマン・デジタルツイン(HDT)は、人の生体情報や行動履歴を基に、個人や特定集団の心理特性や行動傾向をデジタル上に再現する技術です。HDTが扱うのは住所や氏名のような直接の識別情報だけでなく、感情や心理状態、行動傾向のように、文脈によって解釈が変わり得る、不確実性を含んだ機微な情報です。そのため、従来の個人情報とは性質の異なるリスクが生じます。
具体的なリスクとしては、心理特性のような機微な情報(センシティブなデータ)※1を扱うことによる目的外利用や不適切な管理、不当な評価などへの転用の恐れが挙げられます。また、こうした技術の影響を強く受けやすい子どもや、社会的に立場の弱い利用者に対して、どのような保護策を講じるべきかという課題もあります。
こうしたリスクをさらに複雑にしているのが、HDTの「機微な情報を自ら生成し、蓄積し続ける」という特徴です。例えば、TypePのHDT※2、つまり個人単位で動作するHDTは、断片的な生体情報から個人の感じ方や行動傾向を推定し、本人も自覚していないような内面的特性までデジタル化し得るものです。しかも、これらは一時的な出力にとどまらず、学習によって更新される持続的なプロファイル※3として蓄積されます。生成したデータを基に再度学習する設計であれば、時間とともに精度が高まり、個人の内面に深く関わる情報をHDTが抱え続けることもあり得ます。
ここで問題となるのは、HDTのプライバシーリスクは、元データの種類や利用目的を整理するだけでは捉えきれないことです。これは、推論によって生まれた出力や派生データ自体が、機微情報になり得るからです。そのため、元データの利用目的を定めていたとしても、出力データの扱い方や転用、ほかのデータとの統合によってリスクは増幅します。こうして生じた機微な情報が蓄積され、利用者のコントロールの及ばない範囲で保持・利用され続けることは、HDTにおける主要なプライバシーリスクの1つです。
具体的なリスクとしては、心理特性のような機微な情報(センシティブなデータ)※1を扱うことによる目的外利用や不適切な管理、不当な評価などへの転用の恐れが挙げられます。また、こうした技術の影響を強く受けやすい子どもや、社会的に立場の弱い利用者に対して、どのような保護策を講じるべきかという課題もあります。
こうしたリスクをさらに複雑にしているのが、HDTの「機微な情報を自ら生成し、蓄積し続ける」という特徴です。例えば、TypePのHDT※2、つまり個人単位で動作するHDTは、断片的な生体情報から個人の感じ方や行動傾向を推定し、本人も自覚していないような内面的特性までデジタル化し得るものです。しかも、これらは一時的な出力にとどまらず、学習によって更新される持続的なプロファイル※3として蓄積されます。生成したデータを基に再度学習する設計であれば、時間とともに精度が高まり、個人の内面に深く関わる情報をHDTが抱え続けることもあり得ます。
ここで問題となるのは、HDTのプライバシーリスクは、元データの種類や利用目的を整理するだけでは捉えきれないことです。これは、推論によって生まれた出力や派生データ自体が、機微情報になり得るからです。そのため、元データの利用目的を定めていたとしても、出力データの扱い方や転用、ほかのデータとの統合によってリスクは増幅します。こうして生じた機微な情報が蓄積され、利用者のコントロールの及ばない範囲で保持・利用され続けることは、HDTにおける主要なプライバシーリスクの1つです。
「越境」と「集約」、リスクを生む2つの構造
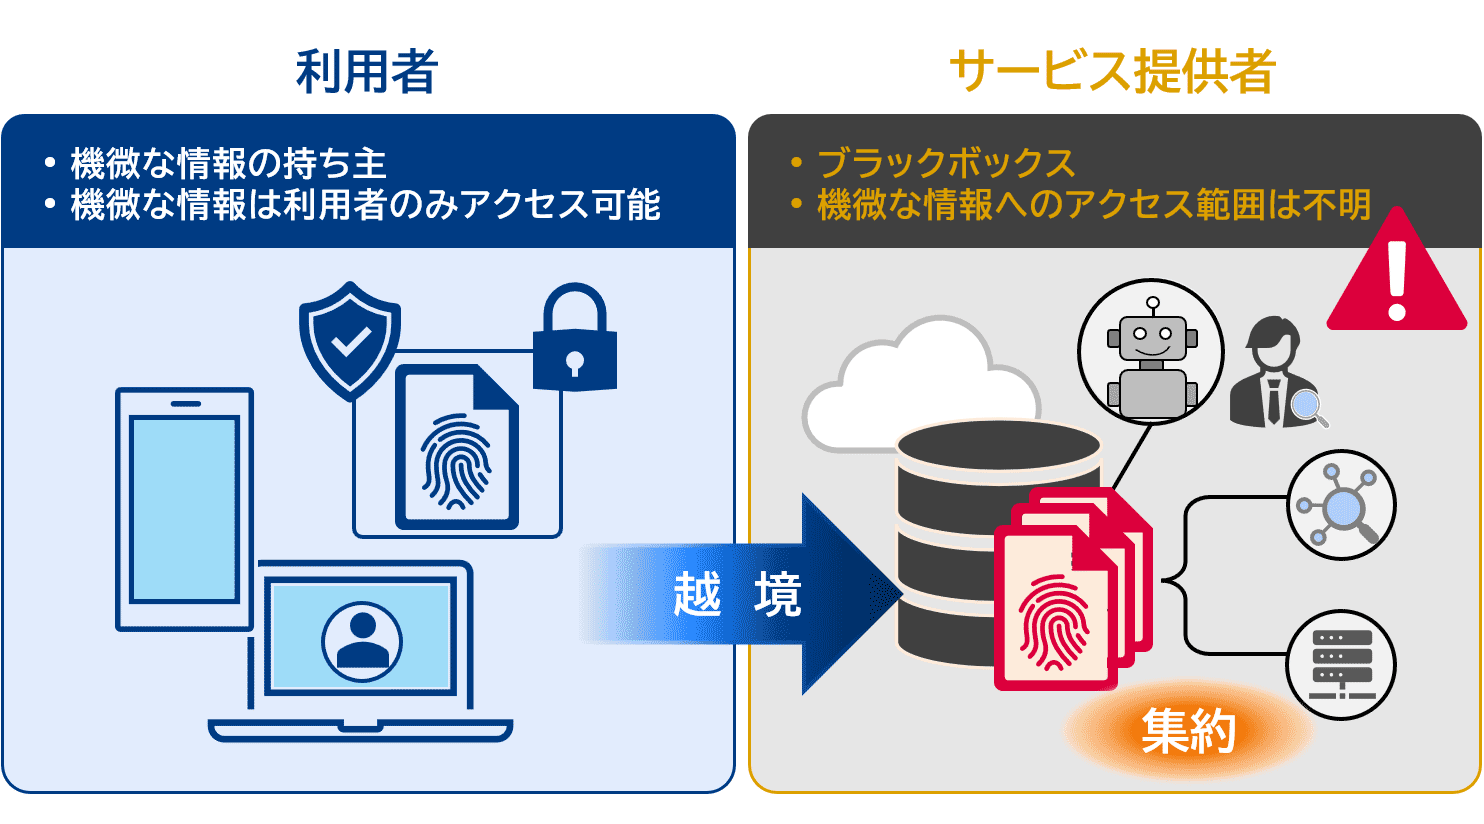
前節で述べたように、TypePのHDTでは、機微な情報が利用者のコントロールの及ばない範囲で保持・利用され続けることが主要なプライバシーリスクとなります。このリスクは、主に「越境」と「集約」という2つの構造で説明できます(図表1)。
図表1 「越境」と「集約」のイメージ
三菱総合研究所作成
まず「越境」とは、機微な情報が、利用者が直接コントロールできる範囲を離れ、外部の管理主体に移ることを指します。例えば、生体情報をクラウド上のHDTで処理するサービスを考えます。この場合、利用者が生体情報をサービス提供者に送信した時点で、その情報は本人が直接コントロール可能な範囲を離れます。これが「越境」です。「越境」が起こると、情報の管理や利用はサービス提供者やその委託先の運用に委ねられます。その結果、当初の想定を超えて、分析やほかのAIの学習など、別の目的に利用される可能性が生じます。また、再委託などが増えるほど、誰がどのような目的で情報を扱っているのかを把握しにくくなります。こうして、情報に対する本人のコントロールは弱まっていきます。
次に「集約」とは、さまざまな情報が1カ所に集まり、相互参照や結合がしやすくなることを指します。「集約」が進むと、単独では重要に見えない情報でも、組み合わせることでプロファイリングや再識別、追跡などのリスクが高まります※4。例えば、クラウド上のHDTを使うサービスでは、利用者が入力した生体情報に加え、HDTが推定した感情や情動に関するデータ※5も蓄積されます。こうしたデータが集まるほど、利用者をより詳細に分析できるようになります。しかも、こうしたデータが「越境」によって利用者のコントロールの及ばない範囲に置かれると、ほかのAIの学習への利用や外部サーバーへの再移転などを止めにくくなります。
対応が難しいのは、越境や集約が、利便性や効率性を追求する中で、悪意がなくても起こり得ることです。例えば、悪意ある第三者が他人の情報から「偽のHDT」を作るなりすましを防ぐため、サービス提供者が利用者のデータを長期間保持し、利用の過程で得られる関連データを継続的に集約して管理することが考えられます。これはなりすまし防止という観点では有効な対策かもしれません。しかしその一方で、データの長期保持や集約は、異なるサービス間でのデータの越境利用や過度なプロファイリング、万一の漏洩時の影響拡大といった、別のプライバシーリスクを高める可能性があります。サービスの質を維持しつつ、越境や集約によるリスクを事前に制御し、最小化するためには、運用面の工夫だけでなく、設計段階から技術的な対策を組み込むことが重要です。
次に「集約」とは、さまざまな情報が1カ所に集まり、相互参照や結合がしやすくなることを指します。「集約」が進むと、単独では重要に見えない情報でも、組み合わせることでプロファイリングや再識別、追跡などのリスクが高まります※4。例えば、クラウド上のHDTを使うサービスでは、利用者が入力した生体情報に加え、HDTが推定した感情や情動に関するデータ※5も蓄積されます。こうしたデータが集まるほど、利用者をより詳細に分析できるようになります。しかも、こうしたデータが「越境」によって利用者のコントロールの及ばない範囲に置かれると、ほかのAIの学習への利用や外部サーバーへの再移転などを止めにくくなります。
対応が難しいのは、越境や集約が、利便性や効率性を追求する中で、悪意がなくても起こり得ることです。例えば、悪意ある第三者が他人の情報から「偽のHDT」を作るなりすましを防ぐため、サービス提供者が利用者のデータを長期間保持し、利用の過程で得られる関連データを継続的に集約して管理することが考えられます。これはなりすまし防止という観点では有効な対策かもしれません。しかしその一方で、データの長期保持や集約は、異なるサービス間でのデータの越境利用や過度なプロファイリング、万一の漏洩時の影響拡大といった、別のプライバシーリスクを高める可能性があります。サービスの質を維持しつつ、越境や集約によるリスクを事前に制御し、最小化するためには、運用面の工夫だけでなく、設計段階から技術的な対策を組み込むことが重要です。
プライバシー保護技術を活かす設計が重要
HDTのリスクを事前に制御し、最小化するためのプライバシー保護技術は、すでに多く存在します※6。例えば、「生体情報そのものをサービス提供者に開示せずにHDTを学習させたい」という要求には、連合学習のような技術が有効な場合があります※7。
もっとも、こうした技術の効果を十分に引き出すには、データフローや学習、推論の設計にあらかじめ組み込むことが重要です。現在運用されている既存システムへの後付けは、高コストになりやすく※8、利用目的や想定リスクに適合しないまま、形式的な実装にとどまる恐れがあります。
そのためにも、設計の初期段階からリスク最小化のための対策を織り込む、プライバシーバイデザインの考え方が重要になります。その出発点となるのが、どのデータを誰に開示するのか、境界と責任をどう設計するのかという要件定義です。こうした整理を初期段階で明確にすることが、プライバシー保護技術を実効的に機能させる前提となります。
そして、その要件定義の内容は、HDTのユースケースによって異なります。HDTのユースケースは多様であり、関与する主体(エンティティ)※9の役割、守るべき情報、許容可能なリスクの範囲は用途によって大きく異なります。例えば、医療分野で治療方針の判断に関わる用途では、高精度で詳細なデータが求められ、誤推定や漏洩の影響も重大になり得ます。他方、エンターテインメント分野で体験の最適化を目的とする用途では、医療ほど詳細なデータを必要としない場合が多く、誤推定も同程度に深刻とは限りません。従って、プライバシー保護の要件は一律に定めればよいわけではなく、必要なデータや失敗時の影響に応じて調整される必要があります。こうした判断を各社に委ねるだけでは、基準がばらつき、保護水準にも差が生じかねません。そこで、用途ごとの違いを踏まえつつ業界横断で参照可能な共通フレームワークが必要になります。
もっとも、こうした技術の効果を十分に引き出すには、データフローや学習、推論の設計にあらかじめ組み込むことが重要です。現在運用されている既存システムへの後付けは、高コストになりやすく※8、利用目的や想定リスクに適合しないまま、形式的な実装にとどまる恐れがあります。
そのためにも、設計の初期段階からリスク最小化のための対策を織り込む、プライバシーバイデザインの考え方が重要になります。その出発点となるのが、どのデータを誰に開示するのか、境界と責任をどう設計するのかという要件定義です。こうした整理を初期段階で明確にすることが、プライバシー保護技術を実効的に機能させる前提となります。
そして、その要件定義の内容は、HDTのユースケースによって異なります。HDTのユースケースは多様であり、関与する主体(エンティティ)※9の役割、守るべき情報、許容可能なリスクの範囲は用途によって大きく異なります。例えば、医療分野で治療方針の判断に関わる用途では、高精度で詳細なデータが求められ、誤推定や漏洩の影響も重大になり得ます。他方、エンターテインメント分野で体験の最適化を目的とする用途では、医療ほど詳細なデータを必要としない場合が多く、誤推定も同程度に深刻とは限りません。従って、プライバシー保護の要件は一律に定めればよいわけではなく、必要なデータや失敗時の影響に応じて調整される必要があります。こうした判断を各社に委ねるだけでは、基準がばらつき、保護水準にも差が生じかねません。そこで、用途ごとの違いを踏まえつつ業界横断で参照可能な共通フレームワークが必要になります。
プライバシー保護のためのフレームワーク
このような共通フレームワークの構築に当たっては、すべての用途に共通して求められる最低限の基準を示しつつ、利用目的や想定される影響の大きさに応じて、追加的な保護要件を設定できるようにすることが重要です。こうした構造により、保護水準の一貫性を確保しながら、用途ごとの違いにも柔軟に対応できます。
HDTでは、これまでに述べた通り、生体情報や行動履歴など、個人に強く結び付いた機微な情報が扱われます。こうした情報では、想定外の用途で利用される「越境」や複数のデータが組み合わさることで新たな意味を持つ「集約」が起こりやすくなります。その結果、プロファイリングや再識別、追跡可能性の増大といったリスクが高まります。
さらに、リスクは個人に合わせて最適化された悪意ある誘導や、意思決定の歪みといったかたちで現れることもあります。これらは因果関係の立証が難しく、本人も被害に気付きにくいという特徴があります。そのため、問題が起きてから是正するだけでは十分な対応が難しく、影響が継続・拡大する恐れがあります。
従って、HDTの共通フレームワークでは、事前対応を基本とする仕組みを整備しつつ、技術やリスクの変化に応じて柔軟に更新可能なかたちでの運用が求められます。
参考になるのが、日本のAI政策で形成されつつある重層的な枠組みです。現在は、AI法(人工知能関連技術の研究開発及び活用の推進に関する法律)が基本理念と推進体制を定め、その上の共通指針が横断的な考え方を示し、そこに各主体や各分野の実務的な対応が積み重なるかたちになっています。ただし、現行制度は絶対的な水準を一律に定めるものではなく、各主体の自主的な取り組みを促す性格が強いため、具体的な要件や運用水準にはばらつきが生じやすい状況になっています。
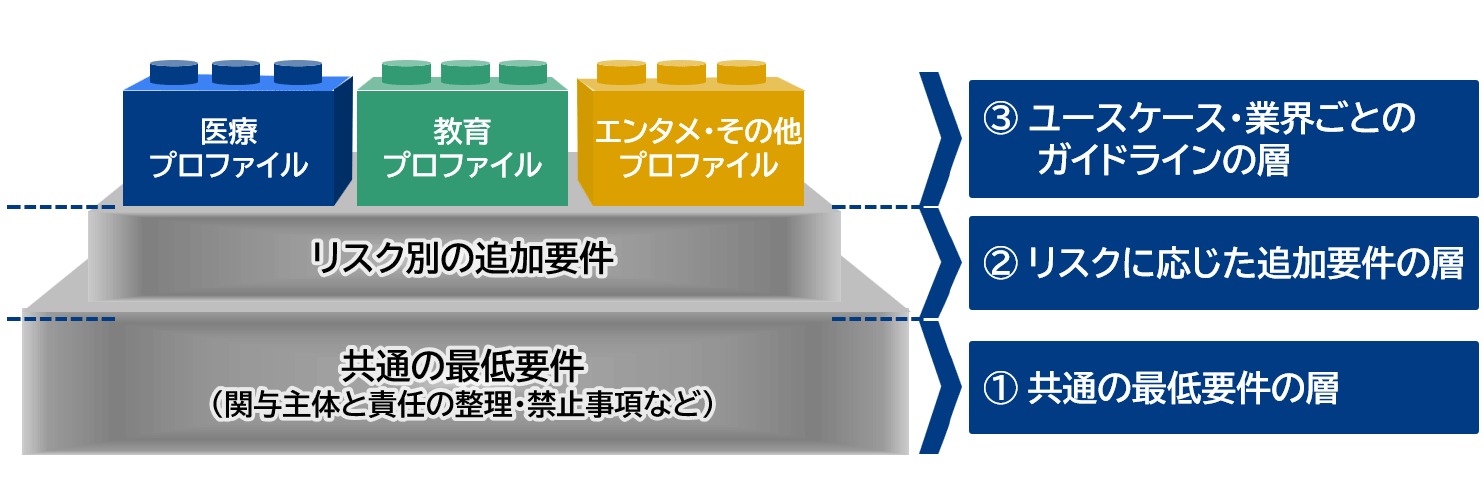
そこでHDTのフレームワークは、こうした課題を踏まえ、次の3つの層で構成することが考えられます(図表2)。
HDTでは、これまでに述べた通り、生体情報や行動履歴など、個人に強く結び付いた機微な情報が扱われます。こうした情報では、想定外の用途で利用される「越境」や複数のデータが組み合わさることで新たな意味を持つ「集約」が起こりやすくなります。その結果、プロファイリングや再識別、追跡可能性の増大といったリスクが高まります。
さらに、リスクは個人に合わせて最適化された悪意ある誘導や、意思決定の歪みといったかたちで現れることもあります。これらは因果関係の立証が難しく、本人も被害に気付きにくいという特徴があります。そのため、問題が起きてから是正するだけでは十分な対応が難しく、影響が継続・拡大する恐れがあります。
従って、HDTの共通フレームワークでは、事前対応を基本とする仕組みを整備しつつ、技術やリスクの変化に応じて柔軟に更新可能なかたちでの運用が求められます。
参考になるのが、日本のAI政策で形成されつつある重層的な枠組みです。現在は、AI法(人工知能関連技術の研究開発及び活用の推進に関する法律)が基本理念と推進体制を定め、その上の共通指針が横断的な考え方を示し、そこに各主体や各分野の実務的な対応が積み重なるかたちになっています。ただし、現行制度は絶対的な水準を一律に定めるものではなく、各主体の自主的な取り組みを促す性格が強いため、具体的な要件や運用水準にはばらつきが生じやすい状況になっています。
そこでHDTのフレームワークは、こうした課題を踏まえ、次の3つの層で構成することが考えられます(図表2)。
図表2 共通フレームワークの作り方の例
三菱総合研究所作成
①共通の最低要件の層
行政が、責任主体や役割モデル、禁止事項、最低限の説明可能性などの基本的な定義を明確にし、制度の基盤となる共通のルールを定めます。
②リスクに応じた追加要件の層
一定のリスク水準に応じて必要となる追加要件を整理します。例えば事前評価や適用すべき技術の要件などです。この層は、技術の進歩や新たなリスクに応じて柔軟に更新されることが前提となります。また、この層は①の共通ルールの整備と③のガイドライン策定を接続する中間層として、両者の担い手が協調して具体化・更新することを想定しています。
③ユースケース・業界ごとのガイドラインの層
業界知見を持つ中立的な主体※10が、実務に即して「何を行うべきか」というベストプラクティスを示します。これらのガイドラインは、②の更新に応じて適宜見直されます。
このように、制度の基盤を固定する層と、リスクや技術の変化に応じて更新する層を組み合わせることで、統一的な基準の下で柔軟なリスク対応が可能になります。特に、個人と強く結び付いたTypePのHDTの活用では、事前にリスクの水準を見極め、予防的に対応できる仕組みの強化が必要です。すでに人のデジタルツインを活用するサービス※11は立ち上がりつつあり、脳科学的解析を含む関連技術の研究も進んでいます※12。こうした動向を踏まえると、制度設計や倫理・法的論点の整理は、技術開発の後追いではなく、事前のリスク評価を基礎として、技術や利用形態の変化に応じて見直せる形で並行して進める必要があります。
※1:ここでは生体データや心理データ、感情データなど、本人が容易に変更や撤回するのが難しく、差別や不利益に直結し得る高リスクな情報全般のことを指しています。
※2:三菱総合研究所では、個々人の心の応答をモデル化したHDTをTypeP、類型化された集団の心の応答をモデル化したHDTをTypeC、一般的な人の心の応答をモデル化したHDTをTypeGと分類しています。
ヒューマン・デジタルツインとは何か?「人の心」をサイバー空間に再現する革新技術 心とデジタルの融合(1)(3Xによる行動変容の未来2030 2025年7月10日)
※3:ここでの「持続するプロファイル」とは、氏名や年齢といった基本属性に加え、行動履歴などから推定される嗜好や傾向が、時間とともに更新されながら蓄積された情報のまとまりを指します。
※4:個人情報保護法で定められた処理(匿名化など)が施されていても、データが大規模に集約されている場合、それ自体が外部情報との照合対象となり得ます。実際、Netflix Prizeで公開された匿名加工済みの映画評価データセットについて、インターネット上の公開レビュー情報との突合から、特定のユーザーを高い確率で再識別できることが示されており(How To Break Anonymity of the Netflix Prize Dataset)、個々のレコードが限定的な情報しか含まない場合でも、大規模に集約されることで、再識別のリスクや攻撃対象としての価値が飛躍的に高まることが示唆されています。
Arvind Narayanan, Vitaly Shmatikov, “How To Break Anonymity of the Netflix Prize Dataset”
https://arxiv.org/abs/cs/0610105(閲覧日:2026年3月25日)
※5:感情や情動に関する推測データは、これもまた機微な情報として扱うべきです。
※6:OECDの資料や、情報政策リーダーシップセンター(CIPL)の資料などを参照すると、多くのプライバシー保護技術が存在することがわかります。
OECD “Emerging privacy-enhancing technologies”
https://www.oecd.org/content/dam/
CIPL, “Understanding the Role of PETs and PPTs in the Digital Age”
https://www.informationpolicycentre.com/
※7:連合学習(フェデレーテッドラーニング)と呼ばれる技術は、学習元のデータをほかに開示することなく機械学習を行うことを可能にします。しかし、学習結果からの推測リスクなどもあるため、追加の対策が必要になることもあります。
※8:一般に、設計後の変更は設計初期の変更よりコストが大きくなりやすいことが知られています。2002年のレポートですが、NISTは欠陥修正コストが発見時期に強く依存することを示しており、運用・保守段階での修正は要件定義段階での修正の470〜880倍、設計変更を伴う場合には約2900倍に達する可能性を報告しています。
G. Tassey, “The Economic Impacts of Inadequate Infrastructure for Software Testing,” Technical Report, NIST, 2002.
https://www.nist.gov/system/files/
※9:ここでは利用者、サービス提供者、データ管理者、行政機関、悪意ある第三者など、HDTに関わる可能性があるさまざまなエンティティを考慮する必要があります。
※10:中立的な主体の在り方については、何か一律のモデルを想定する必要はありません。業界団体が十分な知見と独立性を持つ場合はその団体が担えばよく、専門性と倫理性が高度に求められる高リスク領域では、専門家を中心とする外部団体が担うことも考えられます。重要なのは、分野ごとに適切な主体を定めつつ、リスク類型や判断材料を継続的に更新し、安全と利便性のバランスを最適な状態に保つことです。
※11:例えば電通のPeople Modelや、博報堂のバーチャル生活者など、国内の複数企業から人のデジタルツインを活用したサービスが出始めています。これらのサービスは社内での利用を前提として作られたものであり、本コラムで指摘するようなリスクを直接的に有するサービスではありません。
電通ウェブサイト「AI For Growth - Labs & Projects(ラボ&プロジェクト)」
https://www.dentsu.co.jp/labo/
博報堂ニュースリリース「博報堂、生成AIで生活者発想を支援するサービスプロトタイプを開発 自社の生活者調査データベースから7,000タイプのバーチャル生活者を生成—AIを生活者の声を聴くイマジネーション・パートナーへ—」(2024年3月22日)
https://www.hakuhodo.co.jp/news/
※12:アラヤのPersona Labなど。
https://lp.araya.org/neuroai/
著者紹介
連載一覧
関連するナレッジ・コラム
-
 2026年10月19日【提言】AIロボティクスを「使いこなす」社会へ
-
 2026年10月16日フロンティア(宇宙・海洋・量子)への挑戦で世界はどう変わるか?
-
 2026年10月06日【提言】人の「心」をモデル化するAI
-
 2026年10月01日自社固有技術を実装したフィジカルAIの開発・実装に向けて
-
2026年09月09日フィジカルAI搭載ロボットの積極的な活用を進めよう
-
2026年09月04日専門人材の共有ハブとしてのロボット・サービスプロバイダー
-
2026年09月04日フィジカルAI時代の新規事業としてのロボット・サービスプロバイダー
-
 2026年09月02日ドローン運航を支える新たな衛星通信技術D2C
もっと見る
閉じる